Generative KI
Claude Fable 5.2: Warum der Bestwert nicht die Nachricht ist
Claude Fable 5.2 erreicht bei Humanity’s Last Exam 74,2 Prozent. Für Unternehmen zählt anderes: gleiche Leistung zu deutlich niedrigeren Kosten pro Aufgabe.
Von Sascha Sambale · · 7 Min. Lesezeit
- Generative KI
- KI-Agenten
- ROI
- KI-Strategie
 KI-generiert
Claude Fable 5.2 ist seit dem 9. November 2026 verfügbar. Das neue Spitzenmodell von Anthropic erreicht beim Test Humanity’s Last Exam 74,2 Prozent, den höchsten Wert im Vergleich des Herstellers. Für Unternehmen steckt die wichtigere Nachricht eine Zeile tiefer. Das Modell liefert die Leistung des bisherigen Arbeitspferds Opus 5.5 zu einem Bruchteil der Kosten pro Aufgabe.
Humanity’s Last Exam gilt als einer der härtesten Tests für Sprachmodelle. Er umfasst 2.500 Fragen auf Expertenniveau aus Dutzenden Fachgebieten, entwickelt vom Center for AI Safety und dem Unternehmen Scale AI. Der Test entstand, weil führende Modelle ältere Prüfungen fast vollständig lösten.
Zugleich senkt Anthropic den Preis. Fable 5.2 kostet acht US-Dollar je eine Million Input-Token und 40 US-Dollar je eine Million Output-Token. Der Vorgänger Fable 5.1 lag bei zehn und 50 US-Dollar. Der Preis sinkt damit um 20 Prozent.
Was hat Fable 5.2 bei Humanity’s Last Exam erreicht?
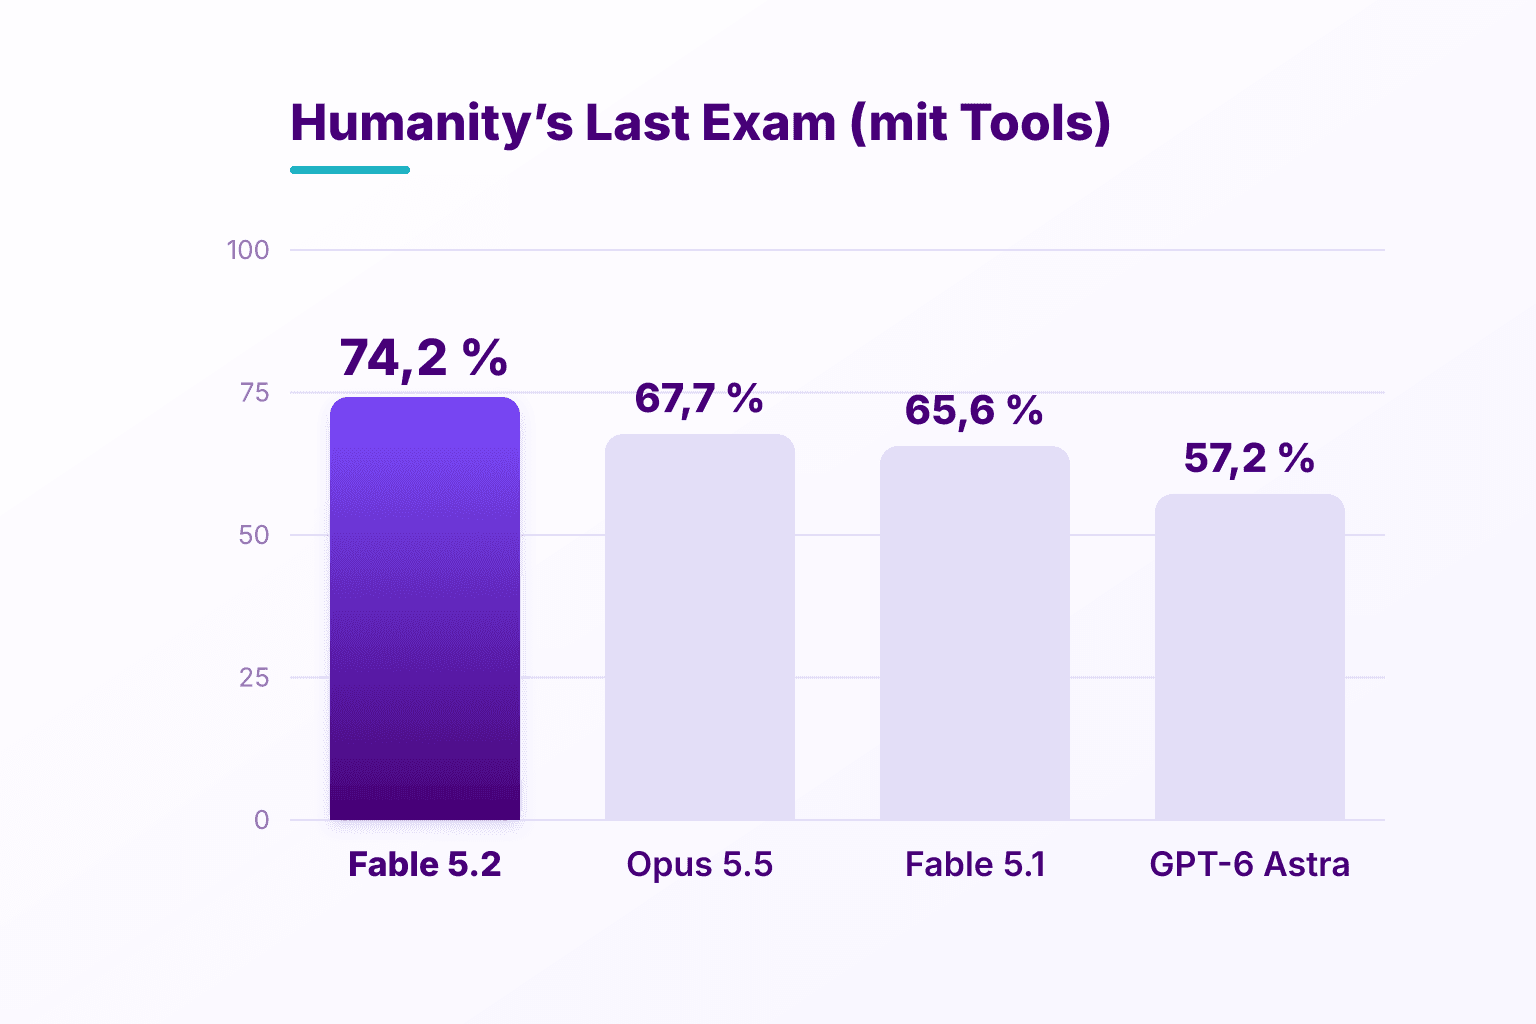
Fable 5.2 löst laut Anthropic 74,2 Prozent der Aufgaben, wenn das Modell Werkzeuge einsetzen darf. Der Vorgänger Fable 5.1 kam auf 65,6 Prozent, Opus 5.5 auf 67,7 Prozent und GPT-6 Astra von OpenAI auf 57,2 Prozent. Für Gemini 4 Carbon von Google nennt die Tabelle keinen Wert.
 KI-generiert
Zwei Einschränkungen gehören dazu. Die Zahlen stammen vom Hersteller selbst und sind bislang nicht unabhängig bestätigt. Von einem Rekord spricht Anthropic in der Ankündigung auch nicht. Den Anspruch auf den höchsten Wert aller getesteten Modelle erhebt das Unternehmen nur für den Programmiertest FrontierCode 2.0.
Der Abstand zum Vorgänger ist dennoch bemerkenswert. Knapp neun Prozentpunkte innerhalb einer Modellgeneration sind bei einem Test, der eigens gegen schnelle Sättigung gebaut wurde, ein großer Schritt.
Wo liegt Fable 5.2 vorn und wo nicht?
In Anthropics Vergleich führt Fable 5.2 bei Softwareentwicklung, Computerbedienung und langen eigenständigen Aufgaben. Bei automatisierten Geschäftsabläufen liegt dagegen Gemini 4 Carbon knapp vorn. Wer ein Modell für einen bestimmten Prozess auswählt, sollte deshalb auf den passenden Test schauen und nicht auf den Gesamteindruck.
| Test (Angaben in Prozent) | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|
| FrontierCode 2.0 (Programmieren mit Agenten) | 49,1 | 45,5 | 42,8 | 41,1 |
| FrontierSWE v2 (Programmieren mit Agenten) | 69,9 | 62,3 | 65,5 | 61,2 |
| AutomationBench (Geschäftsabläufe) | 51,4 | 42,5 | 41,4 | 53,9 |
| OSWorld 2.1 (Computerbedienung) | 89,3 | 87,2 | 79,5 | 81,5 |
| Remote Labor Index (Aufträge wie für Freiberufler) | 41,3 | 21,3 | 20,8 | keine Angabe |
| Humanity’s Last Exam (mit Tools) | 74,2 | 67,7 | 57,2 | keine Angabe |
Alle Werte stammen aus der Ankündigung von Anthropic. Am deutlichsten fällt der Abstand beim Remote Labor Index aus, der vollständige Aufträge prüft: Fable 5.2 schließt dort fast doppelt so viele ab wie Opus 5.5. Eine erste unabhängige Einordnung liefert der Bewertungsdienst Vals AI. In dessen Vals Index steht Fable 5.2 mit 71,31 Prozent auf Platz eins von 36 Modellen.
Wie schneiden Google, Meta und Alibaba ab?
Auch für die neuesten Modelle von Google, Meta und Alibaba liegen Werte bei Humanity’s Last Exam vor. Sie stammen aus unterschiedlichen Messungen und lassen sich deshalb nur grob vergleichen.
| Modell | Anbieter | Wert in Prozent | Messung |
|---|---|---|---|
| Claude Fable 5.2 | Anthropic | 74,2 | Anthropic, mit Tools |
| Claude Opus 5.5 | Anthropic | 61,4 | Artificial Analysis |
| Gemini 4 Carbon | 60,4 | Artificial Analysis | |
| Gemini 4 Argon | 57,1 | Artificial Analysis | |
| Muse Wonder Full | Meta | 53,6 | Meta |
| Qwen3.8 Max | Alibaba | 43,6 | Alibaba |
Der unabhängige Bewertungsdienst Artificial Analysis testet alle Modelle unter einheitlichen Bedingungen. Fable 5.2 war dort zum Zeitpunkt dieses Artikels noch nicht gelistet. Wie stark die Testbedingungen das Ergebnis prägen, zeigt Opus 5.5: In Anthropics Messung mit Tools erreicht das Modell 67,7 Prozent, bei Artificial Analysis 61,4 Prozent.
Der Vorsprung von Fable 5.2 dürfte in einer einheitlichen Messung also kleiner ausfallen, als die Tabelle nahelegt. Die Reihenfolge ist dennoch erkennbar. Google liegt mit Gemini 4 Carbon dicht hinter Anthropic, Meta und Alibaba folgen mit Abstand.
Die eigentliche Nachricht sind die Kosten pro Aufgabe
Fable 5.2 erreicht die Qualität von Opus 5.5 mit deutlich weniger Aufwand. Auf niedriger Effort-Stufe kommt das Modell bei Humanity’s Last Exam auf den Bestwert von Opus 5.5, für weniger als ein Zehntel der Kosten pro Aufgabe, so Anthropic. Die Effort-Stufe legt fest, wie gründlich ein Modell nachdenkt und wie viele Token es dafür verbraucht.
Das Muster wiederholt sich beim Programmieren. Auf der Stufe „High“ erreiche Fable 5.2 bei FrontierCode 45,3 Prozent und damit praktisch den Bestwert von Opus 5.5 mit 45,5 Prozent, zu etwa der Hälfte der Kosten pro Aufgabe. Außerdem seien die Ausgaben bis zu 30 Prozent schneller als beim Vorgänger.
Bemerkenswert ist das, weil Opus 5.5 pro Token nur halb so viel kostet: vier US-Dollar je eine Million Input-Token und 20 US-Dollar je eine Million Output-Token. Das teurere Modell ist hier trotzdem das günstigere, weil es mit weniger Schritten und weniger Token ans Ziel kommt. Der Preis pro Token sagt also wenig über die Rechnung am Monatsende.
Für die Planung folgt daraus eine neue Stellschraube. Neben der Wahl des Modells entscheidet die Effort-Stufe über Kosten und Qualität, und sie lässt sich pro Aufgabe einstellen.
Was zeigen die Beispiele für tagelange Agentenarbeit?
Sie zeigen, dass Teams aus KI-Agenten inzwischen über Tage an einer Aufgabe arbeiten können. Ein KI-Agent ist ein System, das ein Ziel verfolgt, Werkzeuge nutzt und mehrere Arbeitsschritte selbst ausführt. Anthropic beschreibt zwei Fälle, in denen Fable 5.2 jeweils rund 1.000 solcher Agenten koordiniert hat.
Im ersten Fall entstand aus einem Prototyp ein Betriebssystem, das auf einem Laptop startet. Die Agenten arbeiteten dafür acht Tage rund um die Uhr. Im zweiten Fall formalisierte ein Agententeam den Beweis des Großen Fermatschen Satzes in 30 Stunden. Die erste Formalisierung hatte elf Tage gedauert. Opus 5.5 habe im selben Aufbau in 18 Stunden nur 26 Prozent geschafft, teilt Anthropic mit.
Aber Achtung: Das sind Vorführungen des Herstellers unter Idealbedingungen, mit klarem Ziel und überprüfbarem Ergebnis. Im Unternehmen sind Ziele selten so eindeutig. Je länger Agenten selbstständig arbeiten, desto wichtiger werden feste Rollen, Rechte und Kontrollen. Wie das aussehen kann, beschreibt der Artikel KI-Agenten brauchen eine Personalakte.
Was müssen Unternehmen vor dem Einsatz wissen?
Drei Punkte aus der Ankündigung betreffen den Betrieb direkt: die Aufbewahrung der Daten, die Schutzfilter und die Verfügbarkeit. Alle drei sollten geklärt sein, bevor das Modell produktive Daten sieht.
Datenaufbewahrung. Anthropic speichert Ein- und Ausgaben bei Fable 5.2 für die Sicherheitsüberwachung 30 Tage lang. Ein Betrieb ganz ohne Aufbewahrung ist nur für berechtigte Kunden möglich. Wer personenbezogene Daten verarbeitet, sollte das mit dem Datenschutzbeauftragten prüfen.
Schutzfilter. Fable 5.2 blockiert riskante Anfragen zur Cybersicherheit, etwa Penetrationstests und das Erzeugen von Exploits, sowie die meisten Aufgaben der Forschungsbiologie. Solche Anfragen beantwortet dann ein älteres Modell. Gegenüber dem Vorgänger gebe es rund 55 Prozent weniger Blockaden, so Anthropic. Die Variante ohne diese Filter heißt Mythos 5.2 und steht nur geprüften Organisationen offen.
Verfügbarkeit. Das Modell ist über Anthropic selbst sowie über Amazon Web Services, Google Cloud und Microsoft Azure erhältlich. Für Unternehmen mit bestehendem Cloud-Vertrag entfällt damit ein neuer Beschaffungsweg.
Was Unternehmen jetzt tun sollten
- Eigene Testaufgaben zusammenstellen. Einige Dutzend echte Fälle aus dem eigenen Prozess sagen mehr über den Nutzen als jede Rangliste.
- Die Kosten pro erfolgreichem Ergebnis messen, nicht den Preis pro Token. Dazu gehören Fehlversuche und die Zeit für Kontrolle und Nacharbeit.
- Effort-Stufen durchprobieren. Oft genügt eine niedrige Stufe, und die höchste lohnt sich nur für wenige schwierige Fälle.
- Das Modell pro Arbeitsschritt wählen. Spitzenmodelle gehören in Planung und Ausnahmen, kleine Modelle und klassische Software in die Routine.
- Datenaufbewahrung und Schutzfilter gegen die eigenen Anforderungen prüfen, bevor produktive Daten fließen.
Welche Prozesse sich für einen ersten Test eignen, lässt sich in einem KI-Workshop mit den Fachbereichen klären. Wie daraus eine Architektur mit dem passenden Modell für jeden Schritt wird, beschreibt die Seite zur KI-Beratung für den Mittelstand.
Das heißt: Die Rangliste ändert sich mit jeder Veröffentlichung, und der nächste Bestwert kommt bestimmt. Beständig ist die Frage, was eine erledigte Aufgabe kostet. Wer seine Prozesse so aufgebaut hat, dass sich Modell und Effort-Stufe austauschen lassen, profitiert von jedem neuen Modell, ohne neu anfangen zu müssen.
Häufige Fragen
Was ist Claude Fable 5.2?
Claude Fable 5.2 ist das leistungsfähigste allgemein verfügbare Sprachmodell von Anthropic, veröffentlicht am 9. November 2026. Es ist für anspruchsvolle Aufgaben gedacht, die viele Arbeitsschritte über Stunden oder Tage erfordern, etwa Softwareentwicklung mit Agenten. Technisch ist es dasselbe Modell wie Claude Mythos 5.2, hat aber Schutzfilter für Cybersicherheit und Biologie. Dadurch kann Anthropic es allen Kunden anbieten, über die eigene Plattform sowie über Amazon Web Services, Google Cloud und Microsoft Azure.
Was kostet Claude Fable 5.2?
Nach Angaben von Anthropic kostet Claude Fable 5.2 acht US-Dollar je eine Million Input-Token und 40 US-Dollar je eine Million Output-Token. Das sind 20 Prozent weniger als beim Vorgänger Fable 5.1 mit zehn und 50 US-Dollar. Der Schnellmodus mit bis zu 2,5-facher Ausgabegeschwindigkeit kostet das Doppelte, also 16 und 80 US-Dollar. Entscheidend für die Rechnung ist aber, wie viele Token eine Aufgabe insgesamt verbraucht.
Was ist Humanity’s Last Exam?
Humanity’s Last Exam ist ein Test für Sprachmodelle mit 2.500 Fragen auf Expertenniveau aus Dutzenden Fachgebieten. Entwickelt haben ihn das Center for AI Safety und das Unternehmen Scale AI zusammen mit Fachleuten aus aller Welt. Der Test entstand, weil führende Modelle ältere Prüfungen fast vollständig lösten und sich Fortschritt damit kaum noch messen ließ. Er prüft Fachwissen und Schlussfolgern, nicht den Nutzen im Arbeitsalltag eines Unternehmens.
Was ist der Unterschied zwischen Claude Fable 5.2 und Mythos 5.2?
Beide sind laut Anthropic dasselbe zugrunde liegende Modell. Fable 5.2 hat Schutzfilter, die riskante Anfragen zu Cybersicherheit und die meisten Aufgaben der Forschungsbiologie blockieren, und ist dafür allgemein verfügbar. Mythos 5.2 arbeitet ohne diese Filter und steht nur geprüften Organisationen offen, die in diesen Bereichen tätig sind, etwa in der IT-Sicherheit oder den Lebenswissenschaften. Für die meisten Unternehmen ist Fable 5.2 die relevante Variante.
Was neue KI-Modelle für Ihr Unternehmen bedeuten
Die Keynote ordnet neue Modelle wie Claude Fable 5.2 ein: was Benchmarks aussagen, wo sich der Einsatz rechnet und welche Entscheidungen für Geschäftsführung und IT jetzt anstehen.
Keynote anfragenQuellen
- Introducing Claude Fable 5.2 and Claude Mythos 5.2 – Anthropic, 09.11.2026
- Pricing – Anthropic, Claude Platform Docs
- Humanity's Last Exam – Center for AI Safety und Scale AI, arXiv, 24.01.2025
- Claude Fable 5.2 Benchmarks, Cost and Capabilities – Vals AI
- Humanity's Last Exam Benchmark Leaderboard – Artificial Analysis
- AA-HLE Leaderboard & Scores – November 2026 – BenchLM (Daten: Artificial Analysis)
- Meta Muse Wonder: Top Benchmarks Challenge Claude and GPT – IAMAG (Daten: Meta)
- Qwen3.8-Max: Features, Benchmarks, and Pricing – DataCamp (Daten: Alibaba)